


学习云存储需要了解的一些技术知识
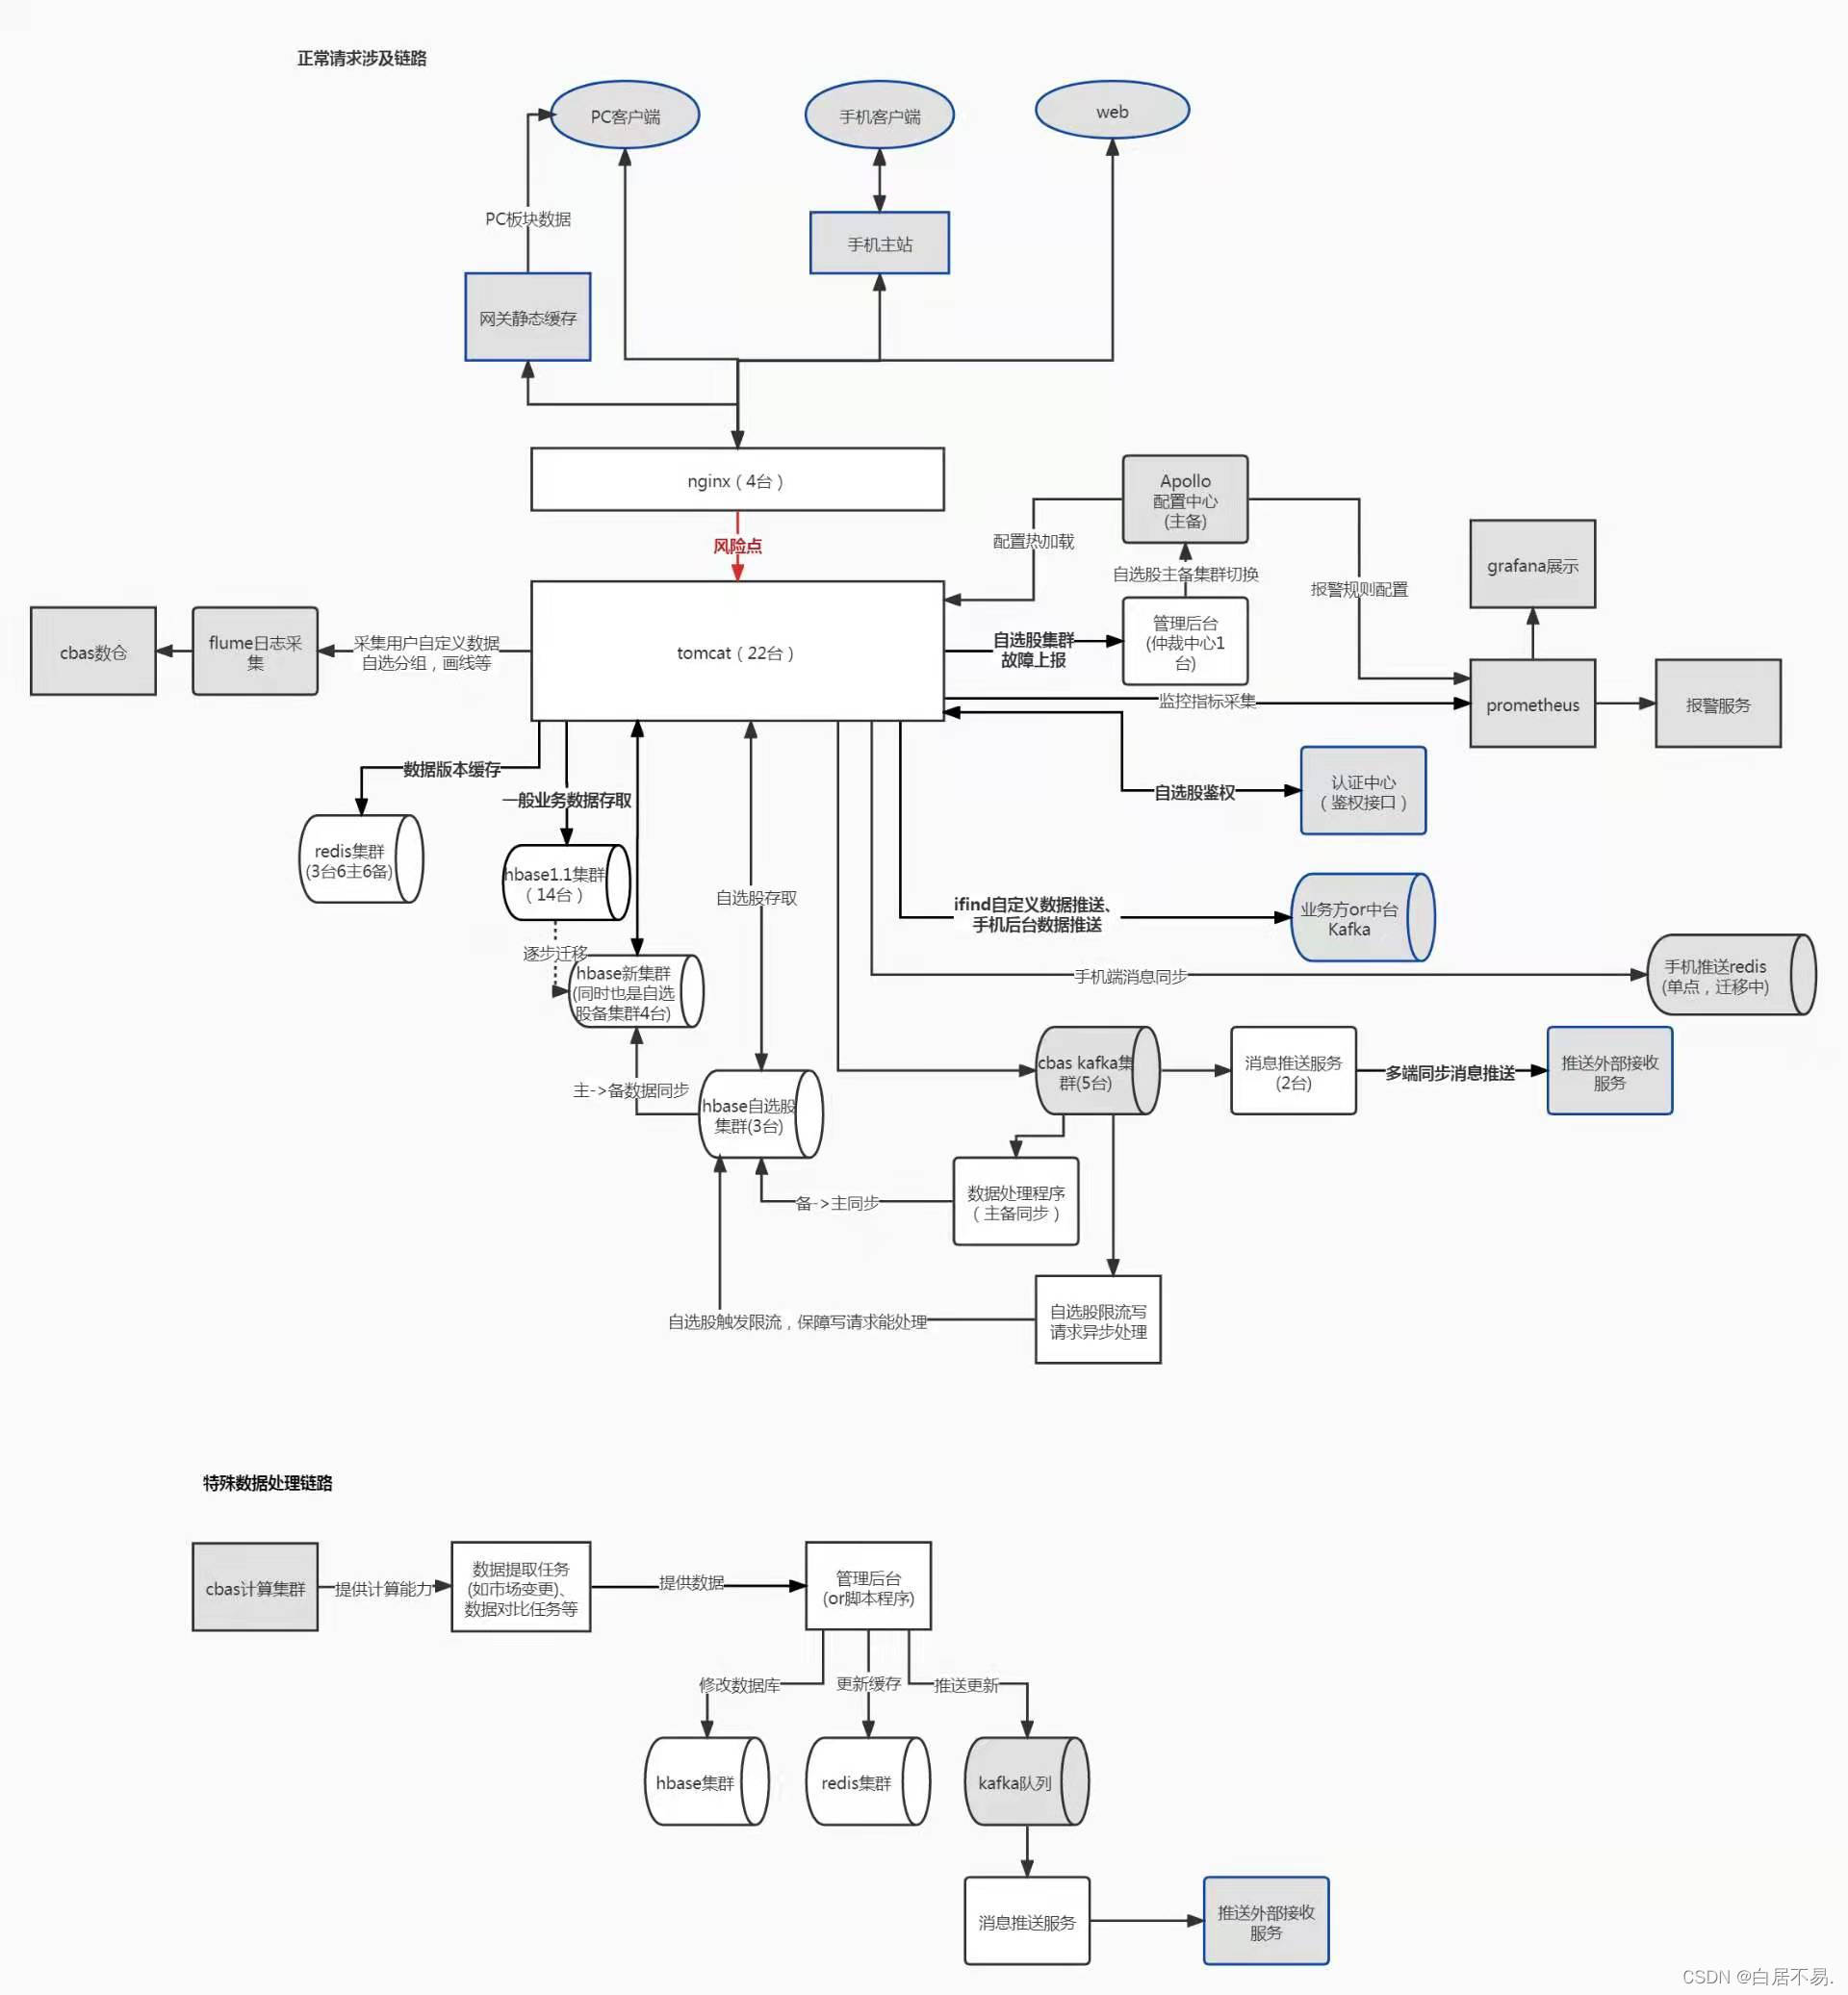
首先,云存储通用接口业务流程图如下所示:
其次,就是一些名词的解释。
1. 分布式
不同的业务模块部署在不同的服务器上或者同一个业务模块分析多个子业务,部署在不同的服务器上,解决高并发的问题,提供可扩展性,以及高可用性,业务中使用分布式的场景主要有分布式存储以及分布式计算。分布式存储中可以将数据分片到多个节点上,不仅可以提高性能(可扩展性),同时也可以使用多个节点对同一份数据进行备份。
2. 单点模式与集群
**单点模式:**Java EE 项目部署在一台tomcat 上,所有的请求都由这一台机器处理,问题很大。
并发处理能力因为单点服务器的性能有限制,所以单台tomcat的最大连接数有限。
容错率低,一旦服务器故障,项目无法正常运行。
单独的服务器计算能力低,无法完成复杂的海量数据计算。
**集群:**多台服务器集中实现相同的项目。每台服务器存在的作用缓解高并发,发生故障转移服务到另外的空闲服务器上。(同一个业务部署在多态机器上,提高系统可用性。)
高可用性。单点模式出现错误,会导致服务无法访问。高可用性集群及时服务中出现错误,会由其他节点代替故障节点,系统环境并没有改变。
伸缩性。一组服务器,各自分担处理任务,我们只需要将新的服务器加入集群即可,对于客户端来说,服务并没有发生变化。
负载均衡。程序处理负载或网络流量负载在计算机集群中均衡分担处理,并且可以动态分配负载。
3. 分布式锁
当多个进程不在同一个系统中,用分布式锁控制多个进程对资源的访问。
3.1 分布式锁应该具备的条件
原子性。在分布式系统环境下,只有一个客户端能持有锁;加锁和解锁必须是同一个客户端,客户端自己不能把别人加的锁给解了。
容错性。高可用的获取锁和释放锁。只要大部分的Redis节点正常运行,客户端就可以加锁和解锁。
高性能。获取锁和释放锁的操作消耗小。
可重入。同一线程在为释放锁时,如果再次申请锁资源不需要走申请流程,只需要将已经获取的锁继续返回,并且记录上已经重入的次数即可。
具备锁失效机制,防止死锁。即使有一个客户端在持有锁的期间崩溃而没有主动解锁,也能保证后续其他客户端能加锁。
可阻塞。这把锁最好是一把阻塞锁(根据业务需求考虑要不要这条),阻塞锁即没有获取到锁,则继续等待获取锁;非阻塞锁即没有获取到锁后,不继续等待,直接返回获取锁失败。
3.2 三种实现方式
① 基于数据库实现分布式锁
简单来说,就是创建一张锁表,通过操作数据方式实现。用锁时增加记录,释放锁是删除记录。每次获取锁时会先查询表中的数据。
基于数据库自带的锁实现。(排他锁)
② 基于缓存(Redis )熟悉爱你分布式锁
③ 基于Zookeeper实现分布式锁
4. Flume(日志采集)
4.1 定义
Flume 是 Cloudera 提供的一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统。Flume 基于流式架构,灵活简单。
**功能:**实时读取服务器本地磁盘的数据,将数据写入到HDFS上。
4.2 Flume 组成架构
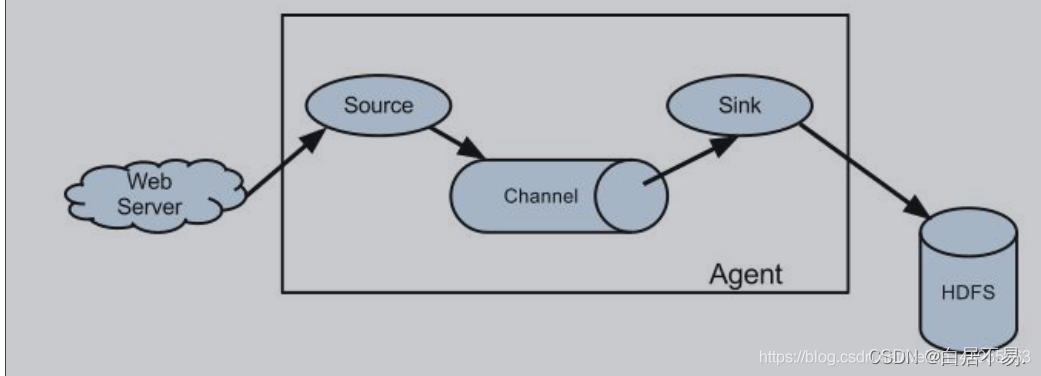
简易架构图:
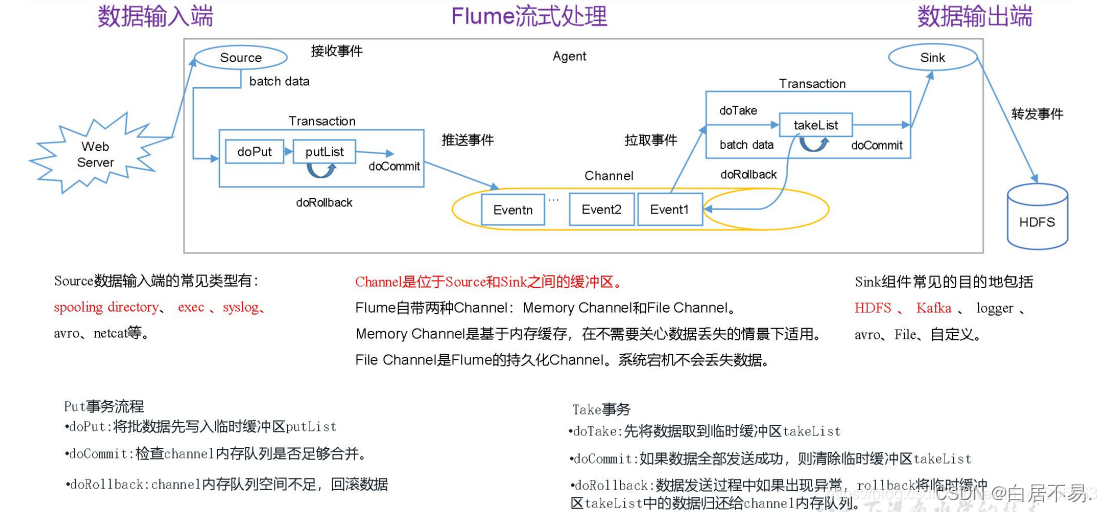
详细架构图
1. 工作流程
Source采集数据并包装成Event,并将Event缓存在Channel中,Sink不断地从Channel获取Event,并解决成数据,最终将数据写入存储或索引系统。
2. Agent
Agent是一个JVM进程,它以事件的形式将数据从源头送至目的,是 Flume 数据传输 的基本单元。
Agent主要有3个部分组成,Source、Channel、Sink
3. Source
Source是负责接收数据到Flume Agent的组件,采集数据并包装成Event。Source组件可以处理各种类型、各种格式的日志数据,包括avro、thrift、exec、jms、spooling directory、netcat、sequence generator、syslog、http、legacy。
4. Channel
Channel是位于Source和Sink之间的缓冲区。因此,Channel允许Source和Sink运作在不同的速率上。Channel是线程安全的,可以同时处理几个Source的写入操作和几个Sink的读取操作。
Flume自带两种Channel:Memory Channel和File Channel。
Memory Channel是内存中的队列。Memory Channel在不需要关心数据丢失的情景下适用。如果需要关心数据丢失,那么Memory Channel就不应该使用,因为程序死亡、机器宕机或者重启都会导致数据丢失
File Channel将所有事件写到磁盘。因此在程序关闭或机器宕机的情况下不会丢失数据
5. Sink
Sink不断地轮询Channel中的事件且批量地移除它们,并将这些事件批量写入到存储或索引系统、或者被发送到另一个Flume Agent。
Sink组件目的地包括hdfs、logger、avro、thrift、ipc、file、HBase、solr、自定义。
6. Event
传输单元,Flume 数据传输的基本单元,以事件的形式将数据从源头送至目的地。。Event由Header和Body两部分组成,Header用来存放该event的一些属性,为K-V结构,Body用来存放该条数据,形式为字节数组.

5. Apollo(配置中心)
5.1 定义
Apollo(阿波罗)是携程框架部门研发的开源配置管理中心,能够集中化管理应用不同环境、不同集群的配置,配置修改后能够实时推送到应用端,并且具备规范的权限、流程治理等特性。
Apollo支持4个维度管理Key-Value格式的配置:
application (应用)
environment (环境)
cluster (集群)
namespace (命名空间)
5.2 特点
配置修改实时生效(热发布)
修改并发布后,客户端能实时(1秒)接收到最新的配置,并通知到应用程序
统一管理不同环境、不同集群的配置
以开源模式开发的,对java、集成spring支持较好
5.3 Apollo 架构和模块
四个核心模块及其主要功能
ConfigService
提供配置获取接口
提供配置推送接口
服务于Apollo客户端
AdminService
提供配置管理接口
提供配置修改发布接口
服务于管理界面Portal
Client
为应用获取配置,支持实时更新
通过MetaServer获取ConfigService的服务列表
使用客户端软负载SLB方式调用ConfigService
Portal
配置管理界面
通过MetaServer获取AdminService的服务列表
使用客户端软负载SLB方式调用AdminService
三个辅助服务发现模块
Eureka
用于服务发现和注册
Config/AdminService注册实例并定期报心跳
和ConfigService住在一起部署
MetaServer
Portal通过域名访问MetaServer获取AdminService的地址列表
Client通过域名访问MetaServer获取ConfigService的地址列表
相当于一个Eureka Proxy
逻辑角色,和ConfigService住在一起部署
NginxLB
和域名系统配合,协助Portal访问MetaServer获取AdminService地址列表
和域名系统配合,协助Client访问MetaServer获取ConfigService地址列表
和域名系统配合,协助用户访问Portal进行配置管理
5.4 依赖
<dependency>
<groupId>com.ctrip.framework.apollo</groupId>
<artifactId>apollo-clientt</artifactId>
<version>1.4.0</version>
</dependency>
5.5 配置的一些基本概念
①配置是独立于程序的只读变量
配置首先是独立于程序的,同一份程序在不同的配置下会有不同的行为。
其次,配置对于程序是只读的,程序通过读取配置来改变自己的行为,但是程序不应该去改变配置。
常见的配置有:DB Connection Str、Thread Pool Size、Buffer Size、Request Timeout、Feature Switch、Server Urls等。
②配置伴随应用的整个生命周期
配置贯穿于应用的整个生命周期,应用在启动时通过读取配置来初始化,在运行时根据配置调整行为。
③配置可以有多种加载方式
配置也有很多种加载方式,常见的有程序内部hard code,配置文件,环境变量,启动参数,基于数据库等。
④配置需要治理
权限控制
由于配置能改变程序的行为,不正确的配置甚至能引起灾难,所以对配置的修改必须有比较完善的权限控制。
不同环境、集群配置管理
同一份程序在不同的环境(开发,测试,生产)、不同的集群(如不同的数据中心)经常需要有不同的配置,所以需要有完善的环境、集群配置管理。
框架类组件配置管理
还有一类比较特殊的配置 - 框架类组件配置,比如CAT客户端的配置。
虽然这类框架类组件是由其他团队开发、维护,但是运行时是在业务实际应用内的,所以本质上可以认为框架类组件也是应用的一部分。
这类组件对应的配置也需要有比较完善的管理方式。
5.6 Apollo配置中心特性
统一管理不同环境、不同集群的配置
Apollo提供了一个统一界面集中式管理不同环境(environment)、不同集群(cluster)、不同命名空间(namespace)的配置。
同一份代码部署在不同的集群,可以有不同的配置,比如zk的地址等。
通过命名空间(namespace)可以很方便的支持多个不同应用共享同一份配置,同时还允许应用对共享的配置进行覆盖。
配置修改实时生效(热发布)
用户在Apollo修改完配置并发布后,客户端能实时(1秒)接收到最新的配置,并通知到应用程序
版本发布管理
所有的配置发布都有版本概念,从而可以方便地支持配置的回滚。
灰度发布
所有的配置发布都有版本概念,从而可以方便地支持配置的回滚。
权限管理、发布审核、操作审计
支持配置的灰度发布,比如点了发布后,只对部分应用实例生效,等观察一段时间没问题后再推给所有应用实例。
客户端配置信息监控
可以在界面上方便地看到配置在被哪些实例使用。
提供Java和.Net原生客户端
提供了Java和.Net的原生客户端,方便应用集成。
支持Spring Placeholder, Annotation和Spring Boot的ConfigurationProperties,方便应用使用(需要Spring 3.1.1+)。
同时提供了Http接口,非Java和.Net应用也可以方便的使用。
提供开放平台API
Apollo自身提供了比较完善的统一配置管理界面,支持多环境、多数据中心配置管理、权限、流程治理等特性。
不过Apollo出于通用性考虑,对配置的修改不会做过多限制,只要符合基本的格式就能够保存。
部署简单
配置中心作为基础服务,可用性要求非常高,这就要求Apollo对外部依赖尽可能地少。
目前唯一的外部依赖是MySQL,所以部署非常简单,只要安装好Java和MySQL就可以让Apollo跑起来。
Apollo还提供了打包脚本,一键就可以生成所有需要的安装包,并且支持自定义运行时参数。
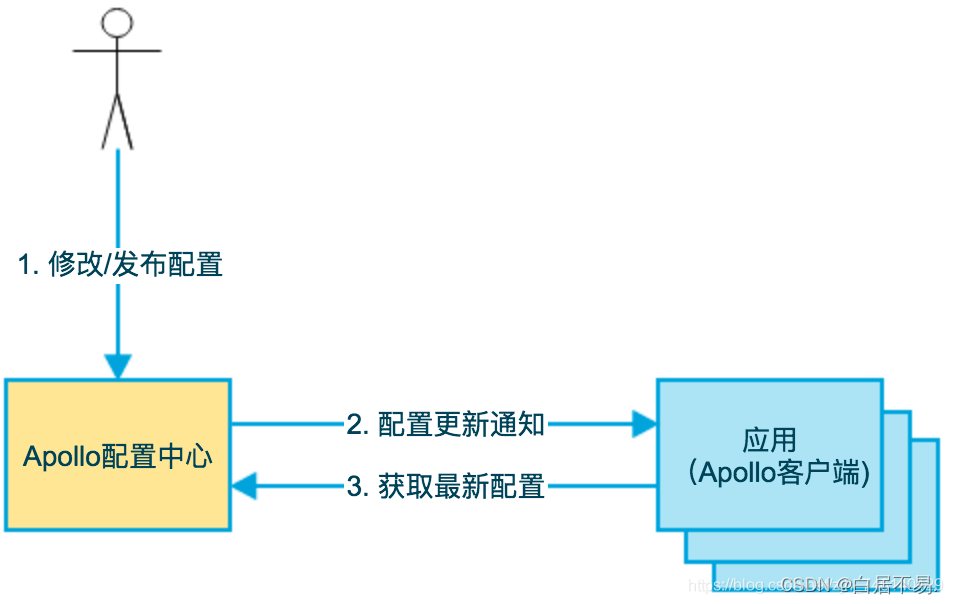
5.7 Apollo配置中心运行流程
①用户在配置中心对配置进行修改并发布
②配置中心通知Apollo客户端有配置更新
③Apollo客户端从配置中心拉取最新的配置、更新本地配置并通知到应用
6. Kafka (分布式发布订阅消息系统)
6.1 定义
由Scala 和Java 编写,Kafka 是一种高吞吐量的分布式发布订阅消息系统,同时Kafka是一种消息队列。主要用来处理大量数据状态下的消息队列,一般用来做日志的处理。既然是消息队列,那么kafka也就拥有消息队列的相应的特性了。
消息队列的好处
解耦合
耦合的状态表示当你实现某个功能的时候,是直接接入当前接口,而利用消息队列,可以将相应的消息发送到消息队列,这样的话,如果接口出了问题,将不会影响到当前的功能。
异步处理
异步处理替代了之前的同步处理,异步处理不需要让流程走完就返回结果,可以将消息发送到消息队列中,然后返回结果,剩下让其他业务处理接口从消息队列中拉取消费处理即可。
流量削峰
高流量的时候,使用消息队列作为中间件可以将流量的高峰保存在消息队列中,从而防止了系统的高请求,减轻服务器的请求处理压力。
6.2 Kafka消费模式
Kafka的消费模式主要有两种:一种是一对一的消费,也即点对点的通信,即一个发送一个接受。第二种为一对多的消费,即一个消息发送到消息队列,消费者根据消息队列的订阅拉取消息消费。
一对一

消息生产者发布消息到Queue队列中,通知消费者从队列中拉取消息进行消费。消息被消费之后则删除,Queue支持多个消费者,但对于一条消息而言,只有一个消费者可以消费,即一条消息只能被一个消费者消费。
一对多
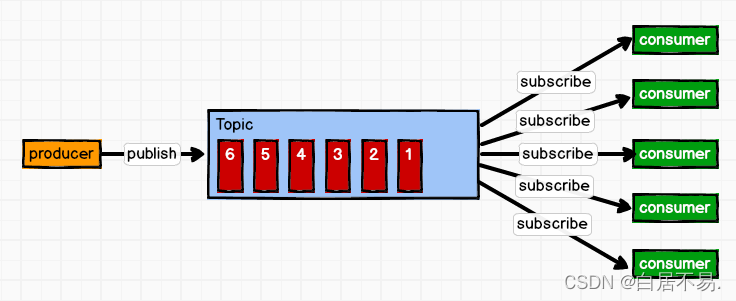
这种模式也成为发布/订阅模式,即利用Topic 存储消息,消息生产者将消息发布到Topic中,同时有多个消费者订阅次topic,消费者可以从中消费消息,注意发布到Topic中的消息会被多个消费者消费,消费者消费数据之后,数据不会被清除,Kafka会默认保留一段时间,然后再删除。
6.3 术语介绍
Kafka像其他Mq一样,也有自己的基础架构,主要存在生产者Producer、Kafka集群Broker、消费者Consumer、注册消息Zookeeper。
Broker:Kafka集群包含一个或多个服务器,这种服务器被称为broker.。
经纪人,一台Kafka服务器就是一个Broker,一个集群由多个Broker组成,一个Broker可以容纳多个Topic
Topic:每条发布在Kafka集群的消息都有一个类别,这个类别被称为Topic。(物理上不同Topic的消息分开存储,逻辑上一个Topic的消息虽然保存于一个或多个broker上但用户只需指定消息的Topic,即可生产或消费数据而不必关心数据存于何处)。
主题,可以理解为一个队列(或者说一系列队列的总称),生产者和消费者都是面向一个Topic。
Partition:Partition是物理上的概念,每个Topic包含一个或多个Partition。
分区,为了实现扩展性,一个非常大的Topic可以分布到多个Broker上,一个Topic可以分为多个Partition,每个Partition是一个有序的队列(分区有序,不能保证全局有序)
Producer:负责发布消息到Kafka broker。
消息生产者,向Kafka中发布消息的角色。
Consumer:消息消费者,从Kafka broker 读取消息的客户端。
Consumer Group:每个Consumer 属于一个特定的Consumer Group(可为每个Consumer指定 group name ,若不指定group name 则属于默认的group)。
消费者组,消费者组则是一组中存在多个消费者,消费者消费Broker中当前Topic的不同分区中的消息,消费者组之间互不影响,所有的消费者都属于某个消费者组,即消费者组是逻辑上的一个订阅者。某一个分区中的消息只能够被一个消费者组中的一个消费者所消费。
Replica:副本Replication,为保证集群中某个节点发生故障,节点上的Partition数据不丢失,Kafka可以正常的工作,Kafka提供了副本机制,一个Topic的每个分区有若干个副本,一个Leader和多个Follower。
Leader:每个分区多个副本的主角色,生产者发送数据的对象,以及消费者消费数据的对象都是Leader。
Follower:每个分区多个副本的从角色,实时的从Leader中同步数据,保持和Leader数据的同步,Leader发生故障的时候,某个Follower会成为新的Leader。
上述一个Topic会产生多个分区Partition,分区中分为Leader和Follower,消息一般发送到Leader,Follower通过数据的同步与Leader保持同步,消费的话也是在Leader中发生消费,如果多个消费者,则分别消费Leader和各个Follow中的消息,当Leader发生故障的时候,某个Follow会成为主节点,此时会对齐消息的偏移量。
6.4 消费模式
MQ的原理:一般MQ都是在服务端存储一个队列,生产者把消息丢到MQ server,消费者从MQ server 消费。这样一来解决了生产者和消费者的高耦合问题,同时也解决了生产速度和消费速度差异导致的消费者跟不上生产者的生产速度而导致的消费者压力过大的问题。
在Kafka中的Topic 就是一系列队列的总称,称为一个主题。一类消息都会丢到一个Topic 中去。
Partition是Kafka独有的东西,也是kafka实现横向扩展和高并发的一个重要设计。试想一下,如果每个Topic只有一个队列,随着业务增加Topic 里消息越来越来、多,躲到一台server装不下了怎么办,为了解决这个问题,我们引入了Partition这个概念。一个Partition(分区)代表了一个物理上存在的队列。Topic只是一组Partition(分区)的总成,也就是说Topic仅是逻辑上的概念。这样一来,当Topic上的消息越来越多,我们就可以将新增的Partition(分区)放在其他server上。
Consumer Group(消费组)顾名思义就是一组Consumer(消费者)的总称。那有了组的概念以后能起到什么作用?如果只有一组且组内只有一个Consumer,那这个就是传统的点对点模式,如果有多组,每组内都有一个Consumer,那这个就是发布-订阅(pub-sub)模式,每组都会收到同样的消息。
7. Prometheus(监控报警系统)
7.1 简介
Prometheus是一个最初在SoundCloud上构建的开源系统监控和警报工具包。
从2012年开始,许多公司和组织开始使用prometheus,该项目拥有非常活跃的开发人员和用户社区。目前它是一个独立的开源项目,并且不依赖于任何公司。为了情调这一点,并澄清项目的治理结构,Prometheus在2016年加入Cloud Native Computing Foundation,作为kubernetes 之后的第二个托管项目。
Exporter是一个采集监控数据并通过Prometheus监控规范对外提供数据的组建,能为Prometheus提供监控的接口。
Exporter将监控数据采集的端点通过HTTP服务的形式暴露给Prometheus Server,Prometheus Server通过访问该Exporter提供的Endpoint 端点,即可获取到需要采集的监控数据。不同的Exporter负责不同的业务。
7.2 特点
多维数据模型(时间序列数据由metric和一组key/value 组成)
在多维度上灵活的查询语言(PromQl)
不依赖分布式存储,单主节点工作,支持本地和远程存储
可以通过服务发现或者静态配置去获取要采集的目标服务器
多种可视化图表及仪表盘支持
7.3 组件及架构
组件
prometheus生态系统由多个组件组成,其中许多组件是可选的。
prometheus server:主要获取和存储时间序列数据
exporters:主要是作为agent收集数据发送到prometheus server,不同的数据收集由不同的exporters实现,如监控主机有node-exporters,mysql有mMySQL server exporters…
pushgateway:推送网关,用于接收各节点推送的数据并暴露给Prometheus server。允许短暂和批处理的jobs推送它们的数据到prometheus;由于这类工作的存在时间不够长,所以需要他们主动将数据推送到pushgateway,然后由pushgateway将数据发送到prometheus。
alertmanager:实现prometheus 的告警功能。处理由客户端应用程序(如Prometheus server)发送的警报。它负责将重复数据删除,分组和路由到正确的接收者集成,还负责沉默和抑制警报。
架构
下图说明了Prometheus及其生态系统组建的一些架构:
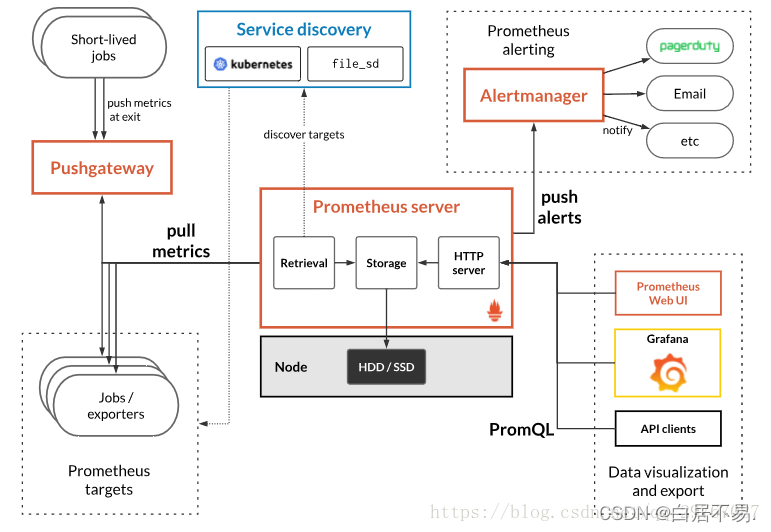
prometheus 直接或通过pushgateway抓取数据。将数据存储在本地,并对这些数据运行规则,以便从现有数据聚合和记录新时间序列,或者生成警报。grafana等可用于可视化数据。
prometheus的使用场景:
prometheus非常适合记录任何纯数字时间序列。它既适合以机器为中心的监视,也适合监视高度动态的面向服务的体系结构。在微服务世界中,它对多为数据收集和查询的支持是一种特别饿优势。
prometheus 的设计旨在提高可靠性,使其成为中断期间要使用的系统,从而使您能够快速诊断问题。每个prometheus服务器都是独立的,而不依赖于网络存储或其他远程服务,当基础设施部分出现问题时仍然可以使用它。
工作流程
其大概的工作流程是:
Prometheus Server直接从HTTP接口或者Pushgateway拉取指标(Metric)数据。
Prometheus Server 在本地存储所有采集的指标(Metric)数据,并在这些数据上运行规则,从现有数据中聚合和记录新的时间序列,或者生成告警。
Alertmanager根据配置文件,对接收到的告警进行处理,发出报警。
在Grafana或其他API客户端中,可视化收集的数据。
指标(Metric):由指标名称 和描述当前数据特征的标签组成。
指标格式:<指标名称>{<标签名称>=<标签值>,…}
指标名称(Metric Name)可以反映被监控数据的含义。指标名称只能由ASCII字符、数字、下划线以及冒号组成并必须符合正则表达式[a-zA-Z_:][a-zA-Z0-9_:]*。
标签(Label)反映了当前数据的特征维度,通过这些维度Prometheus可以对数据进行过滤,聚合等操作。标签的名称只能由ASCII字符、数字以及下划线组成并满足正则表达式[a-zA-Z_][a-zA-Z0-9_]*。
8. Grafana(监控信息的可视化工具)
8.1 简介
Grafana 是一个跨平台的开源的度量分析和可视化工具,可以通过将采集的数据查询然后可视化的展示,并及时通知。它主要有以下六大特点:
展示方式:快速灵活的客户端图表,面板插件有许多不同方式的可视化指标和日志,官方库中具有丰富的仪表盘插件,比如热图、折线图、图表等多种展示方式;
数据源:Graphite,InfluxDB,OpenTSDB,Prometheus,Elasticsearch,CloudWatch和KairosDB等;
通知提醒:以可视方式定义最重要指标的警报规则,Grafana将不断计算并发送通知,在数据达到阈值时通过Slack、PagerDuty等获得通知;
混合展示:在同一张表中混合使用不同的数据源,可以基于每个查询指定数据源,甚至自定义数据源;
注释:使用来自不同数据源的丰富事件注释图表,将鼠标悬停在事件上会显示完整的时间元数据和标记;
过滤器:Ad-hoc过滤器允许动态创建新的键/值过滤器,这些过滤器会自动应用于使用该数据源的所有查询。
Grafana 是一个开源的度量分析与可视化套件。经常被用作基础设施的时间序列数据和应用程序分析的可视化,它在其他领域也被广泛的使用包括工业传感器、家庭自动化、天气和过程控制等。
Grafana 支持许多不同的数据源。每个数据源都有一个特定的查询编辑器,该编辑器定制的特性和功能是公开的特定数据来源。每个数据源的查询语言和能力都是不同的。你可以把来自多个数据源的数据组合到一个仪表盘,但每一个面板被绑定到一个特定的数据源,它就属于一个特定的组织。
8.2 一些基本概念
Data Source:grafana确切的说是一个前端展示工具,将数据以非常美观直接的图形展示出来。那么这些数据必须有一个来源吧,grafana获取数据的地方就成为Data Source。官方文档上说grafana支持以下数据源:Graphite,InfluxDB,OpenTSDB,Prometheus,Elasticsearch,CloudWatch。在Grafana 3.0+之后,grafana不仅仅支持上面说的这些数据源,还支持一些其他的数据源,这些就被称为Grafana Plugins,grafana支持的插件非常多(grafana支持的插件传送门),只要做一些简单的插件安装配置,你就能获取丰富的数据源。
DashBoard:仪表盘,就像汽车仪表盘一样可以展示很多信息,包括车速,水箱温度等。Grafana的DashBoard就是以各种图形的方式来展示从Datasource拿到的数据。
Row:DashBoard的基本组成单元,一个DashBoard可以包含很多个row。一个row 可以展示一种信息或者多种信息的组合,比如系统内存使用率,CPU五分钟及十分钟平均复杂等。所以在一个DashBoard上可以集中展示很多内容。
Panel:面板,实际上就是row展示信息的方式,支持表格(table),列表(alert list),热图(Heatmap)等多种方式。
Query Editor:用来指定获取那一部分的数据。类似于sql查询语句,比如你要在某个row里面展示test这张表的数据,那么Query Editor 里面就可以写成 select * from test。这只是一个比方,实际上每个DataSource 获取数据的方式都不一样,所以写法也不一样,比如像zabbix,数据是以指定某个监控项的方式来获取的。
Organization:(组织)org是一个很大的概念,每个用户可以拥有多个org,grafana有一个默认的main org。用户登录后可以在不同的org之间切换,前提是该用户拥有多个org。不同的org之间完全不一样,包括datasource,dashboard等都不一样。创建一个org就相当于开了一个全新的视图,所有的datasource,dashboard等都要再重新开始创建。
User:Grafana里面用户有三种角色admin,editor,viewer。admin权限最高,可以执行任何操作,包括创建用户,新增Datasource,创建DashBoard。editor角色不可以创建用户,不可以新增Datasource,可以创建DashBoard。viewer角色尽可以查看DashBoard。
9. Sentinel(轻量级流量控制产品)
9.1 简介
随着为服务的流行,服务和服务之间的稳定性变得越来越重要。Sentinel是面向分布式服务架构的轻量级流量控制产品,主要以流量为切入点,从流量控制、熔断降级、系统负载保护等多个维度来帮助您保护服务的稳定性。
9.2 Sentinel 基本概念
资源
资源是Sentinel的关键概念。它可以是Java应用程序中的任何内容,例如,由应用程序提供的服务,或由应用程序调用的其他应用提供的服务,甚至可以是一段代码。
只要通过Sentiel API 定义的代码,就是资源,能够被Sentinel 保护起来。大部分情况下,可以使用方法签名,URL ,甚至服务名称作为资源名来标识资源。
规则
围绕资源的实时状态设定的规则,可以包括流量控制规则、熔断降级规则以及系统保护规则。所有规则可以动态实时调整。
9.3 Sentinel 功能和设计理念
流量控制
流量控制在网络传输中是一个常用的概念,它用于调整网络包的发送数据。然而,从系统稳定性角度考虑,在处理请求的速度上,也有非常多的讲究。任意时间到来的请求往往是随机不可控的,而系统的处理能力是有限的。我们需要根据系统的处理能力对流量进行控制。Sentinel作为一个调配器,可以根据需要把随机的请求调整成合适的形状。
流浪控制的设计理念
流量控制有以下几个角度:
资源的调用关系,例如资源的调用链路,资源和资源之间的关系;
运行指标,例如QPS、线程池、系统负载等;
控制的效果,例如直接限流、冷启动、排队等。
Sentinel的设计理念是让您自由选择控制的角度,并进行灵活组合,从而达到想要的效果。
熔断降级
除了流量控制意外,降低调用链路中的不稳定资源也是Sentinel 的使用之一。由于调用关系的复杂性,如果调用链路中的某个资源出现了不稳定,最终会导致请求发生堆积。这个问题和 Hystrix 里面描述的问题是一样的。
Sentinel 和 Hystrix的原则是一致的:当调用链路中某个资源出现不稳定,例如,表现为timeout,异常比例升高的时候,则对这个资源的调用进行限制,并让请求快速失败,避免影响到其他的资源,最终产生雪崩的效果。
熔断降级设计理念
在限制的手段上,sentinel和Hystrix 采取了完全不一样的方法。
Hystrix通过线程池的方式,来对依赖(在我们的概念中对应资源)进行了隔离。这样做的好处是资源和资源之间做到了最彻底的隔离。缺点是除了增加了线程切换的成本,还需要预先给各个资源做线程池大小的分配。
Sentinel 对这个问题采取了两种手段:
通过并发线程数进行限制
和线程池隔离的方法不同,Sentinel 通过限制资源并发线程的数量,来减少不稳定资源对其他资源的影响。这样不但没有现成切换的损耗,也不需要您预先分配线程池的大小。当某个资源出现不稳定的情况下,例如响应时间变长,对资源的直接影响就是会造成线程数的逐步堆积。当线程数在特定资源上堆积到一定的数量之后,对该资源的新请求就会被拒绝。堆积的线程完成任务后才开始继续接受请求。
通过响应时间对资源进行降级
除了对并发线程数进行控制以外,Sentinel还可以通过响应时间来快速降级不稳定的资源。当依赖的资源出现响应时间过长后,所有对该资源的访问都会被直接拒绝,直到过了指定的时间窗口之后才重新恢复。
系统负载保护
Sentinel 同时对系统的维度提供保护。防止雪崩,是系统防护中重要的一环。当系统负载较高的时候,如果还持续让请求进入,可能会导致系统崩溃,无法相应。在集群环境下,网络负载均衡会把本来这台机器承载的流量转发到其它的机器上去。如果这个时候其它的机器也处于一个边缘状态的时候,这个增加的流量就会导致这台机器也崩溃,最后导致整个集群不可用。
针对这个情况,Sentinel 提供了对应的保护机制,让系统的入口流量和系统的负载达到一个平衡,保证系统在能力范围之内处理最多的请求。
9.4 工作机制
Sentinel 的主要工作机制如下:
对主流框架提供适配或者显示的API,来定义需要保护的资源,并提供设施对资源进行实时统计和调用链路分析。
根据预设的规则,结合对资源的实时统计信息,对流量进行控制。同时,Sentinel 提供开放的接口,方便您定义及改变规则。
Sentinel 提供实时的监控系统,方便您快速了解目前系统的 状态。
————————————————
版权声明:本文为CSDN博主「白居不易.」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/weixin_45866849/article/details/123219131

